গুগলের নতুন আরএসআই অর্জন ওপেন সোর্স করা হয়েছে।
নামকরণ করা হয়েছে জোতা²এটি বড় মডেলগুলিকে রানটাইমের সময় তাদের নিজস্ব প্লাগ-ইন কোড, সিস্টেম প্রম্পট, টুলচেইন এবং দক্ষতা লাইব্রেরিগুলি স্বয়ংক্রিয়ভাবে পরিবর্তন করতে সক্ষম করে।
হ্যাঁ, এটি হারনেস স্তরে RSI।
পারফরম্যান্স অত্যন্ত চিত্তাকর্ষক.
GLM-5 Harness² এর সাথে সংযুক্ত হওয়ার পর, অফিস বেঞ্চমার্ক WorkBuddy-Bench-এ এর সামগ্রিক স্কোর সরাসরি 11.5 পয়েন্ট বেড়েছে।
এটি অবিলম্বে নেটিভ জেমিনি 3.5 ফ্ল্যাশকে ছাড়িয়ে যায়।
পুরো প্রক্রিয়াটির জন্য মডেলের ওজন পরিবর্তন করার প্রয়োজন হয় না, শুধুমাত্র পেরিফেরাল রানটাইম ভারাকে অপ্টিমাইজ করা হয়।
এটি একটি অবিশ্বাস্যভাবে শক্তিশালী অ্যাড-অন: এটির সাথে একত্রিত যেকোন মডেল অবিলম্বে এর বেঞ্চমার্ক স্কোর আকাশচুম্বী দেখতে পাবে।
বর্তমানে, এই প্রকল্পটি সম্পূর্ণরূপে ওপেন-সোর্স করা হয়েছে, এবং OpenCode এবং Codex সমর্থন করে।
কেন “আত্ম-পরিবর্তন” ব্যর্থ হতে থাকে
অতীতে, এজেন্টদের আরও স্মার্ট করার জন্য, শিল্পটি অনেক পুনরাবৃত্ত স্ব-উন্নতি (সংক্ষেপে RSI হিসাবে) প্রচেষ্টা চালিয়েছে।
ধারণাটি খুব আকর্ষণীয় শোনাচ্ছে: AI কে তার নিজস্ব কোড লিখতে দিন, তার নিজস্ব প্রম্পটগুলি সংশোধন করতে দিন এবং নিজস্ব সিস্টেমকে অপ্টিমাইজ করতে দিন। কিন্তু একবার বাস্তব উন্মুক্ত বিশ্বে স্থাপন করা হলে, এই প্রচেষ্টার প্রায় সব ব্যর্থতায় শেষ হয়।
কেন এমন হল?
সমস্যাটি প্রধানত দুটি মারাত্মক ত্রুটির মধ্যে রয়েছে:
কোন আদর্শ উত্তর আছে.
ল্যাবে বেঞ্চমার্ক পরীক্ষা করার সময়, ফলাফল সঠিক কিনা তা জানাতে ইউনিট পরীক্ষা এবং গ্রাউন্ড ট্রুথ রয়েছে। কিন্তু বাস্তব কাজের পরিস্থিতিতে, যেমন একটি ব্যবসায়িক পরিকল্পনা লেখা বা একটি আইনি চুক্তি পর্যালোচনা, আপনার আউটপুট স্কোর করার জন্য অনলাইনে কেউ নেই।
এআই প্রম্পটের একটি সংস্করণ নিজেই পরিবর্তন করার পরে, কীভাবে এটি জানতে পারে যে পরিবর্তনটি এটিকে আরও স্মার্ট করে তোলে বা কেবল এলোমেলো বাজে কথা তৈরি করে?
একটি একক কাজ overfitting.
আপনি একটি নির্দিষ্ট কাজ ঠিক করার জন্য ভারা পরিবর্তন করার জন্য অনেক প্রচেষ্টা ব্যয় করার পরে, যখন পরবর্তী কাজটি একটি ওয়েব ক্রলার লিখতে হয়, তখন পূর্বে সংশোধিত সমস্ত নিয়মগুলি বোঝা হয়ে যায়।
আপনি যদি পরবর্তী কাজটিতে সরাসরি পরিবর্তিত ভারা প্রয়োগ করেন, তাহলে সিস্টেমটি দ্রুত একটি শব্দ সর্পিল হয়ে যাবে এবং প্রতিটি পরিবর্তনের সাথে সাথে বেহাল হয়ে যাবে।
এবার Google টিমের প্রস্তাবিত Harness² এই দুটি মারাত্মক ত্রুটির সমাধানের জন্য বিশেষভাবে ডিজাইন করা হয়েছে।
তারা একটি সেট নির্মাণ করেছে দ্বি-স্তর পুনরাবৃত্ত আর্কিটেকচার.
দ্বি-স্তর পুনরাবৃত্তি: একদিকে পরীক্ষা চালান, অন্যদিকে নোট নিন
Harness² নামের “বর্গাকার” দুটি নেস্টেড রিকারসিভ লুপকে বোঝায়: টাস্ক-স্তরের পুনরাবৃত্তি এবং হারনেসিং-স্তরের পুনরাবৃত্তি.
প্রথম স্তর, টাস্ক-লেভেল রিকারশন: স্ট্যান্ডার্ড উত্তর ছাড়া নিয়ন্ত্রিত পরীক্ষা চালান।
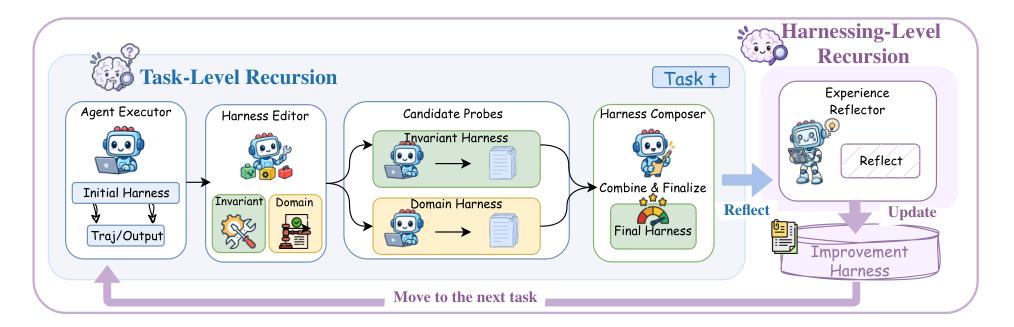
এই নতুন টাস্কের মুখোমুখি হয়ে, সিস্টেমটি প্রথমে একটি রেফারেন্স ট্র্যাজেক্টোরি চালানোর জন্য প্রাথমিক ভারা ব্যবহার করে। এই ফলাফলটি সঠিক কিনা তা বিবেচ্য নয়, মূল কাজটি কার্যকর করার সময় মডেলটি কী ত্রুটি প্রকাশ করে তা খুঁজে বের করা।
এর পরপরই, এটি নামক একটি প্রক্রিয়া শুরু করে প্রপোজ-প্রোব-কম্পোজ:
প্রস্তাব:
একটি নিবেদিত সম্পাদনা ভূমিকা এইমাত্র প্রাপ্ত ট্র্যাজেক্টোরির জন্য দুটি সেট পরিবর্তন পরিকল্পনার প্রস্তাব করে।
একটি সেট হল “ইনভেরিয়েন্ট জেনারেল ডিফেক্ট মেরামত”, যা বিশেষভাবে ক্রস-ডোমেন সাধারণ সমস্যা যেমন বিশৃঙ্খল পরিকল্পনা, টুল কলে অসীম লুপ এবং প্রসঙ্গ বিস্ফোরণ ঠিক করার জন্য ডিজাইন করা হয়েছে;
অন্য সেটটি হল “ডোমেন-নির্দিষ্ট মেরামত”, যা বর্তমান ব্যবসার নির্দিষ্ট জ্ঞান এবং সীমাবদ্ধতার লক্ষ্যে তৈরি।
অনুসন্ধান:
পরিবর্তিত প্রার্থী স্ক্যাফোল্ডিংয়ের এই দুটি সেটকে একই টাস্কে আবার রাখুন এবং আলাদাভাবে চালান।
কোন বিচারক না থাকলে এটা কোন ব্যাপার না, সিস্টেমটি তাদের মৃত্যুদন্ডের গতিপথ ক্যাপচার করে এবং রেফারেন্স ট্র্যাজেক্টোরির সাথে আচরণগত বৈসাদৃশ্য সম্পাদন করে। এটি পরীক্ষা করে যে পরিবর্তনটি পূর্বে আটকে থাকা পদক্ষেপের সমাধান করে কিনা এবং এটি নতুন যৌক্তিক অবক্ষয় ঘটায় কিনা।
রচনা:
সিন্থেসাইজার সমস্ত মৃত্যুদন্ডের প্রমাণ একসাথে রাখে, এমন পরিবর্তনগুলি নির্বাচন করে যা আচরণগত প্রমাণ দ্বারা সত্যই কার্যকর প্রমাণিত হয় এবং সেগুলিকে চূড়ান্ত মৃত্যুদন্ডের স্ক্যাফোল্ডিংয়ে একত্রিত করে।
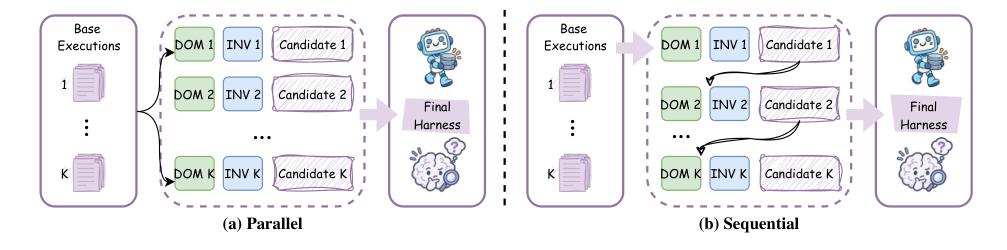
যে সব না. এটি সমান্তরাল পুনরাবৃত্তিকেও সমর্থন করে, যা এক সময়ে সাধারণ এবং ডোমেন প্রার্থী সমাধানগুলির k গ্রুপ তৈরি করে, মোট 2k প্রার্থীর ভারা। সমবর্তী অনুসন্ধানের পরে, k স্বাধীন সংশ্লেষণগুলি অনুসন্ধানের স্থানকে আরও প্রসারিত করতে সঞ্চালিত হয়।
দ্বিতীয় স্তর, হারনেসিং-লেভেল রিকারশন: ভারাকে মেটা-ক্ষমতায় পরিবর্তন করার অভিজ্ঞতাকে প্ররোচিত করুন।
বর্তমান কাজটি সম্পন্ন হওয়ার পরে এবং বিতরণযোগ্য জমা দেওয়ার পরে, অনেক সিস্টেমের জীবনচক্র এখানে শেষ হয়।
কিন্তু হারনেস² এর আসল শক্তি পরে যা আসে তার মধ্যে রয়েছে —
সম্পূর্ণ ডিবাগিং রেকর্ড (রেফারেন্স ট্র্যাজেক্টোরি, প্রার্থী পরিবর্তন, তুলনা প্রমাণ, সংশ্লেষণ সিদ্ধান্ত) এক্সপেরিয়েন্স রিফ্লেক্টর মডিউলের কাছে হস্তান্তর করুন।
পর্যালোচনা করার পরে, প্রতিফলন মডিউলটি একটি EXPERIENCE.md ফাইল লিখবে, যা স্পষ্টভাবে রেকর্ড করে যে কেন পরিবর্তনটি করা হয়েছিল, কোন পরিস্থিতিতে এটি কাজ করে এবং এটি কী পরিণতি নিয়ে আসে এবং এটিকে সংরক্ষণ করে হারনেস ইমপ্রুভমেন্ট লাইব্রেরি.
যখন পরবর্তী নতুন টাস্ক আসে:
মৃত্যুদন্ড শেষ এখনও একটি পরিষ্কার মৌলিক ভারা পায়.
কিন্তু ভারা পরিবর্তনের জন্য দায়ী “উন্নতি মস্তিষ্ক” ইতিমধ্যেই ঐতিহাসিক অভিজ্ঞতার একটি পুরু ম্যানুয়াল রয়েছে। প্রস্তাবনা এবং সংশ্লেষণ পর্বের সময়, এটি অতীতের অনুরূপ পরিস্থিতিতে থেকে সরাসরি কার্যকর উপাদান এবং পিট এড়ানোর নির্দেশিকা পুনরুদ্ধার করতে পারে।
যা উন্নত করা হয়েছে তা কেবল বর্তমান ভারা নয়, ভবিষ্যতে ভারাকে উন্নত করার ক্ষমতাও।
এটি একটি একক কাজের জন্য অস্থায়ী প্যাচকে আজীবন শেখার জন্য একটি জ্ঞানীয় সম্পদে পরিণত করে।
বেঞ্চমার্ক পরীক্ষার ফলাফল
প্রক্রিয়াটি যতই মার্জিত হোক না কেন, এটি শেষ পর্যন্ত বাস্তব-বিশ্বের ডেটা দিয়ে যাচাই করা দরকার।
দলটি সরাসরি তিনটি উচ্চ প্রামাণিক হার্ডকোর পেশাদার বেঞ্চমার্ক গ্রহণ করেছে:
ওয়ার্কবাডি-বেঞ্চ: তিনটি উচ্চ-কঠিন অফিস কার্যপ্রবাহ কভার করে: কোড, ওয়েব এবং অফিস স্যুট;
জববেঞ্চ: দীর্ঘ পরিসরের এন্ড-টু-এন্ড জটিল পেশাদার পোস্ট টাস্ক;
ল্যাব: শীর্ষ আইনি এজেন্ট বেঞ্চমার্ক ওপেন সোর্স হার্ভে দ্বারা.
বেস মডেল নির্বাচিত হয় মিথুন 3.5 ফ্ল্যাশ এবং GLM-5এবং নির্বাচিত এক্সিকিউশন স্ক্যাফোল্ডিং হল মূলধারার ওপেন সোর্স ওপেনকোড এবং কোডেক্স.
ফলাফল অত্যন্ত উল্লেখযোগ্য.
ওয়ার্কবাডি-বেঞ্চ পরীক্ষায়, শুধুমাত্র একক-পদক্ষেপ হারনেস² উন্নতি (k=1) করা হয়েছিল:
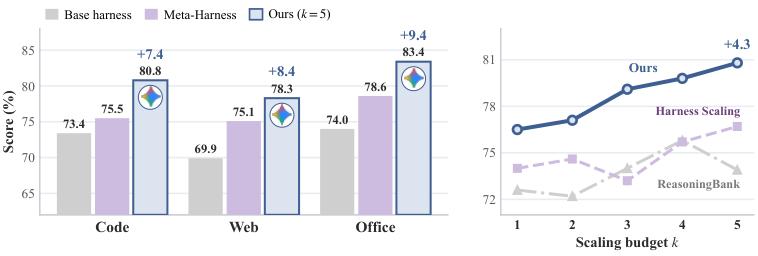
OpenCode-এর অধীনে GLM-5-এর সামগ্রিক স্কোর 64.2 থেকে 75.7-এ বেড়েছে, 11.5 পয়েন্ট বৃদ্ধি পেয়েছে; কোডেক্সের অধীনে, এটি 64.4 থেকে 75.3-এ উন্নীত হয়েছে।
মিথুন 3.5 ফ্ল্যাশ ওপেনকোডের অধীনে 72.4 থেকে 77.5 এবং কোডেক্সের অধীনে 74.5 থেকে 77.5 এ উন্নত হয়েছে।
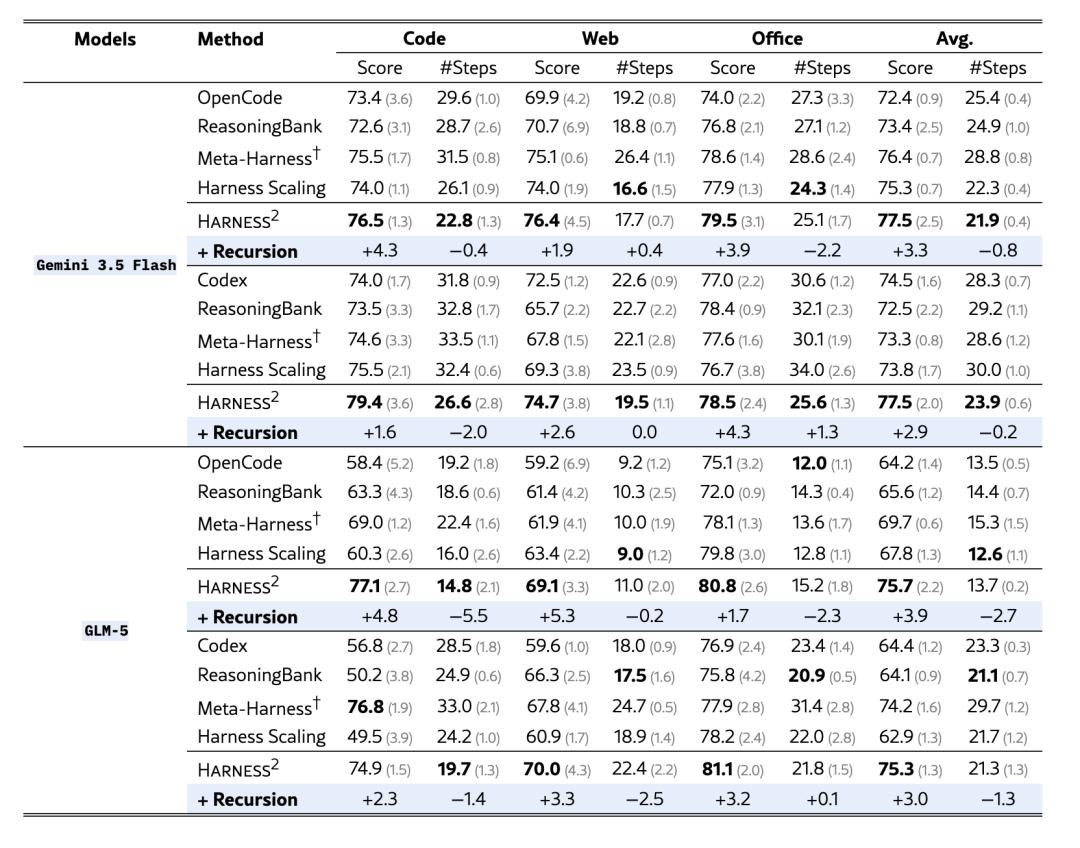
এই তথ্যের দিকে তাকিয়ে:
অপ্টিমাইজড ভারা সহ GLM-5 (75.7 পয়েন্ট / 75.3 পয়েন্ট) সরাসরি মূল অপরিবর্তিত জেমিনি 3.5 ফ্ল্যাশকে ছাড়িয়ে যায় (72.4 পয়েন্ট / 74.5 পয়েন্ট).
এন্ড-টু-এন্ড পোস্ট কাজের জন্য JobBench-এ, একক-পদক্ষেপ উন্নতিও ব্যাপক লাভ নিয়ে আসে: Gemini 3.5 Flash দ্বারা বৃদ্ধি 4.5 পয়েন্টGLM-5 বেড়েছে 3.6 পয়েন্ট; আইনি বেঞ্চমার্ক LAB-তে, GLM-5-এর আংশিক পাসের হার সরাসরি বেড়েছে 11.8 শতাংশ পয়েন্ট.
যদি সমান্তরাল বাজেট কে = 5 (5 সমসাময়িক প্রার্থীর পথ) এ বাড়ানো হয়, তাহলে কর্মক্ষমতা আরও উন্নত হবে: WorkBuddy-Bench সর্বোচ্চ 3.9 পয়েন্টJobBench দ্বারা 4.2 পয়েন্টএবং LAB পাসের হার 6.7 শতাংশ পয়েন্ট.
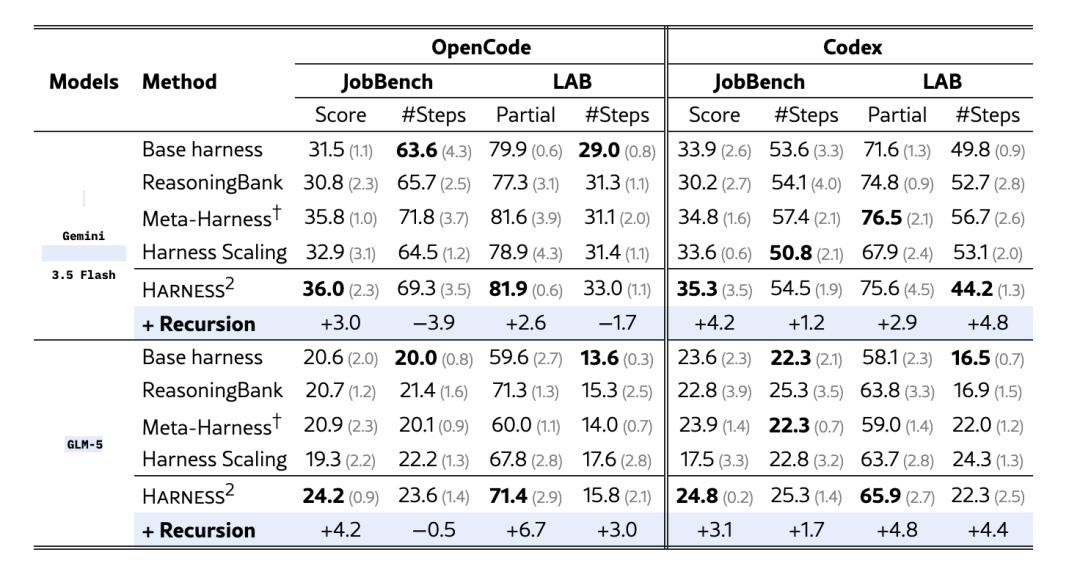
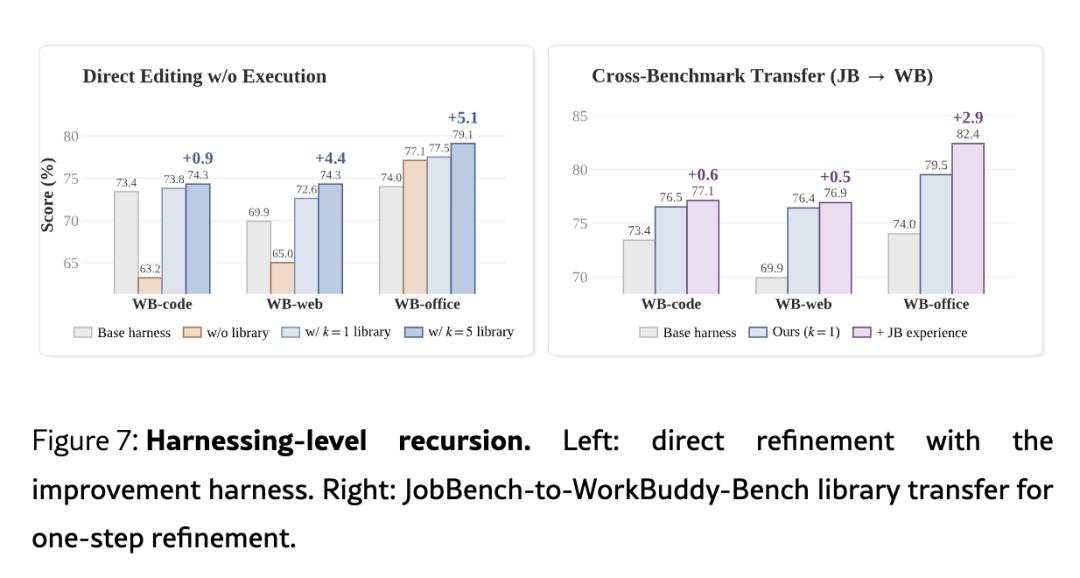
যা আরও চিত্তাকর্ষক তা হল অভিজ্ঞতা লাইব্রেরির ক্রস-ডোমেন স্থানান্তর পরীক্ষা।
টিম JobBench-এ জমে থাকা অভিজ্ঞতার লাইব্রেরি WorkBuddy-Bench-এ স্থানান্তর করেছে, এবং অতিরিক্ত প্রোবিং বাজেট না বাড়িয়ে, একক-পদক্ষেপ হারনেস উন্নতিতে সহায়তা করেছে, যা অবশেষে কোড, ওয়েব এবং অফিসের পরিস্থিতির স্কোর যথাক্রমে 0.6 পয়েন্ট, 0.5 পয়েন্ট এবং 2.9 পয়েন্ট বৃদ্ধি করেছে।
গত দুই বছরে, AI-এর জন্য প্রায় সমস্ত প্রত্যাশা “বেস মডেল স্কেলিং”-এ রাখা হয়েছে, এবং লোকেরা সবসময় মনে করে যে যতদিন GPT-এর পরবর্তী প্রজন্ম প্রকাশিত হবে, ততক্ষণ হাতে থাকা অ্যাপ্লিকেশন সমস্যাগুলি স্বয়ংক্রিয়ভাবে সমাধান হয়ে যাবে।
কিন্তু বাস্তবতা সমস্ত অনুশীলনকারীদের উপর ঠাণ্ডা জল ঢেলে দিয়েছে: বেস মডেলটি আরও বেশি ব্যয়বহুল হয়ে উঠছে, প্রান্তিক সুবিধা হ্রাস পাচ্ছে, এবং বাস্তব স্থাপনার পরিস্থিতিতে লং-টেইল বাগগুলি এখনও অন্তহীন।
আপনি মডেলটি কত বড় প্রসঙ্গ উইন্ডো দেন না কেন, ক্রস-ফাইল অ্যাকাউন্ট পুনর্মিলন প্রক্রিয়া করার সময় এটি এখনও অলস হবে; এর বেঞ্চমার্ক স্কোর যতই উচ্চ হোক না কেন, রিপোর্ট লেখা শেষ করার পর ফর্ম্যাট যাচাই করার জন্য এটি সক্রিয়ভাবে ফাইল খুলবে না।
আরো প্রাক-প্রশিক্ষণ পরামিতি খাওয়ানো দ্বারা এই সমস্যাগুলি সমাধান করা যাবে না।
এটা কি প্রয়োজন একটি সেট রানটাইম জ্ঞানীয় প্রকৌশল যা অপারেশন চলাকালীন স্ব-উপলব্ধি, স্ব-মেরামত এবং ক্রমাগত বিবর্তন করতে পারে।
অতীতে, যখন আমরা স্ক্যাফোল্ডিং তৈরি করতাম, তখন ইঞ্জিনিয়াররা কম্পিউটারের সামনে বসে প্রম্পট লিখতেন, টুলস কনফিগার করতেন এবং লাইন দ্বারা পাইপলাইন লাইন পরিবর্তন করতেন, যা ছিল অত্যন্ত ক্লান্তিকর এবং এখনও ত্রুটিপূর্ণ।
এখন Harness² একটি নতুন পথ প্রমাণ করেছে:
এজেন্টকে নিজেই নিয়ম তৈরি করার ক্ষমতা দিন।
কাগজ লেখক
অবশেষে, আসুন যথারীতি কাগজের লেখকদের পরিচয় করিয়ে দিই।
মোট 9 জন লেখক আছে, এবং চীনা গবেষকদের অনুপাত অত্যন্ত উচ্চ, 78% ছুঁয়েছে…
নিবন্ধের দৈর্ঘ্য সীমিত হওয়ার কারণে, তাদের তিনটি এখানে ক্রমানুসারে উপস্থাপন করা হয়েছে।
রুইয়াও জুকাগজের প্রথম লেখক এবং সংশ্লিষ্ট লেখক।
নর্থওয়েস্টার্ন ইউনিভার্সিটি, ইউএসএ-তে পরিসংখ্যান ও ডেটা সায়েন্স বিভাগের পিএইচডি ছাত্র, অধ্যাপক কাইজ ডিঙের তত্ত্বাবধানে।
তার প্রধান গবেষণা নির্দেশাবলীর মধ্যে রয়েছে বড় ভাষা মডেল, গ্রাফ মেশিন লার্নিং, অসঙ্গতি সনাক্তকরণ এবং এআই এজেন্ট সিস্টেম।
এই কাগজটি তিনি গুগলে তার ইন্টার্নশিপের সময় সম্পন্ন করেছিলেন।
ইয়ানফেই চেনগুগল ক্লাউড এআই গবেষণার সিনিয়র রিসার্চ ইঞ্জিনিয়ার ড.
তিনি পিকিং বিশ্ববিদ্যালয় থেকে বৈদ্যুতিক প্রকৌশল এবং অর্থনীতিতে স্নাতক ডিগ্রি অর্জন করেন এবং 2018 সালে পিটসবার্গ বিশ্ববিদ্যালয় থেকে শিল্প প্রকৌশলে পিএইচডি ডিগ্রি অর্জন করেন।
এর পরে, তিনি মেশিন লার্নিং কোম্পানি Qeexo-এ একজন গবেষণা প্রকৌশলী হিসেবে কাজ করেন এবং 2020 সালে Google-এ যোগ দেন। তিনি Vertex AI সার্চ, জেমিনি এন্টারপ্রাইজ ডিপ রিসার্চের মতো প্রকল্পে অংশগ্রহণ করেছেন এবং তার প্রধান গবেষণার উপর জোর দেওয়া হয়েছে বড় ভাষা মডেল এজেন্ট, পুনরুদ্ধার-বর্ধিত প্রজন্ম এবং টুল লার্নিং।
ঝোংইং কুইঝুZoey CuiZhu নামেও পরিচিত, Google Cloud AI গবেষণার গবেষণা প্রকৌশলী।
তিনি 2019 সালে স্ট্যানফোর্ড ইউনিভার্সিটি থেকে বৈদ্যুতিক প্রকৌশলে তার পিএইচডি অর্জন করেন এবং তার প্রধান গবেষণা নির্দেশাবলী হল সাধারণ এজেন্ট, যাচাইযোগ্য এজেন্ট এবং এজেন্টের গুণমান মূল্যায়ন।
তথ্যসূত্র:
[1]
এই নিবন্ধটি WeChat অফিসিয়াল অ্যাকাউন্ট QbitAI, লেখক: জে, 36Kr দ্বারা প্রকাশের জন্য অনুমোদিত।